Microsoftが第3世代AIチップ「Maia 300」を発表!2027年導入へ、GPU比で電力効率4割向上の実力
 情弱ちゃん
Microsoftが新しい自社製AIチップを発表したみたいだけど、どんな特徴があるの?
 エンマち
第3世代の「Maia 300」だよ!2027年の導入に向けて、推論性能や電力効率が大幅に強化されているんだ。
米Microsoftは10月12日(現地時間)、自社設計AIアクセラレータの第3世代となる「Maia 300」を発表しました。2027年から本番環境への導入を始める計画です。
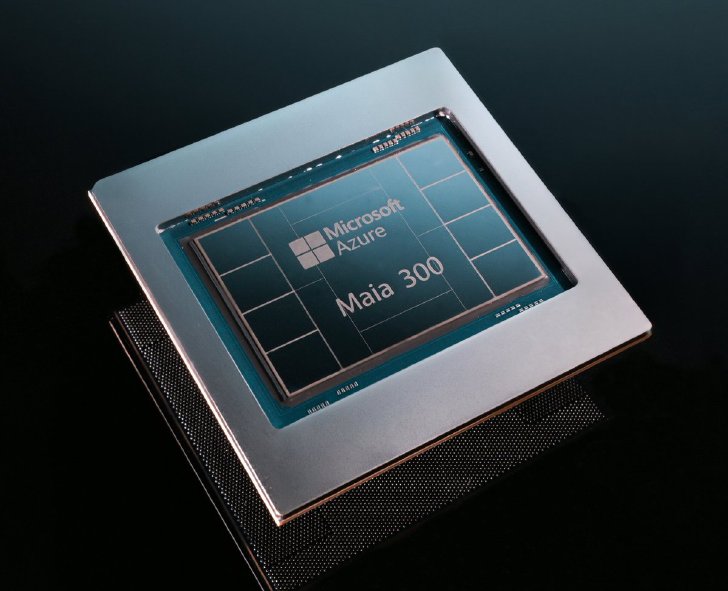
同社は2027年からMaiaファミリーを数ギガワット規模で展開し、自社の製品やサービスで主に利用する推論システムとして位置づけています。サティア・ナデラCEOはXへの投稿において、この取り組みを「自社シリコンへのこれまでで最大の賭け」と表現しました。
処理性能と電力効率の特徴!GPU比でトークン効率が40%向上
Maia 300は、長いコンテキストを扱う推論や遅延に敏感な対話、複数のステップにわたるエージェント型のタスクなど、新しいAIワークロードに向けて設計されています。
主要なGPUベースのシステムと比較して、1メガワット当たりのトークン数は40%増加する見込みです。また、96基で構成するラック全体では、トークン処理能力(スループット)が前世代「Maia 200」の最大7倍に達すると説明されています。
Maia 300のチップ仕様!TSMCの2nmプロセスと288GBのHBM4を搭載
演算部分には台湾TSMCの2nm世代プロセス「N2P」を採用しました。メモリコントローラやI/Oを別のダイに分けるマルチチップレット構成をとっています。
| 項目 | 仕様 |
|---|---|
| 製造プロセス | TSMC 2nm世代(N2P) |
| 演算性能(FP4) | 13.8POPS |
| 演算性能(FP8) | 6.9POPS |
| TDP(熱設計電力) | 950W |
| 搭載メモリ | HBM4(8スタック) |
| メモリ容量 | 288GB |
| メモリ帯域幅 | 18TB/s |
さらに、強化版のMXFP4など低精度の数値形式にも対応しており、演算やKVキャッシュに必要なメモリ量と帯域を削減しています。
情弱ちゃん
ラック単位の性能向上や通信の工夫も盛り込まれているんだね。
エンマち
前世代と比べて最大7倍のスループットを目指していて、約1万2000基を連携させる独自ネットワークも備えているよ。
ラック構成とネットワーク!約1万2000基の大規模スケールアップに対応
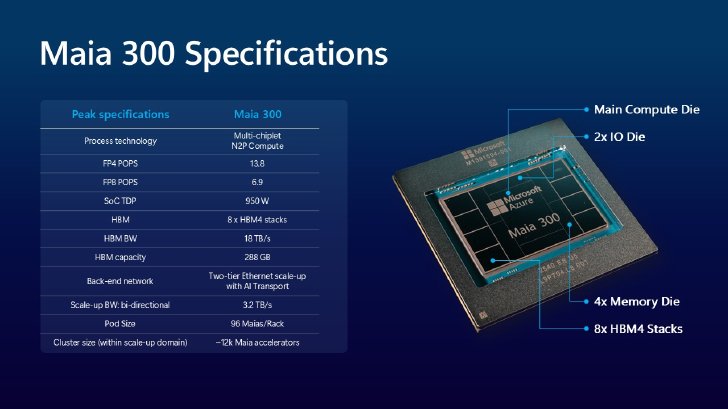
ラック設計では、96基のアクセラレータを167kWの電力枠で収容しています。ラック全体で合計27.6TBのHBM容量と、1.7PB/sの帯域幅を確保しました。
接続にはEthernetをベースにした独自のAI向け通信方式を採用しており、約1万2000基を1つのスケールアップ領域として扱える設計となっています。
先行するMaia 200の稼働実績と展開状況
前世代にあたるMaia 200は1月に発表され、すでに本番環境で稼働しています。現在は「Microsoft Copilot」などのワークロードを処理しているほか、自社AIモデル「MAI」の開発チーム支援にも活用されています。
年内には「GitHub Copilot」や「Microsoft Foundry」へも展開を広げる予定です。システム上では米OpenAIのモデルやMAIモデル、主要なオープンソースモデルが動作しています。
展開地域は米国、欧州、オーストラリアで、Teams、Copilot、Coworkに組み込まれたAI機能においては、主要なGPU基盤と比べて1ワット当たりのトークン数が最大1.7倍を記録しています。
詳細情報は「Microsoft Ignite 2026」で公開予定
Maia 300に関するさらなる詳細は、11月17~20日に米サンフランシスコで開催される年次イベント「Microsoft Ignite 2026」で紹介される予定です。
情弱ちゃん
今後の詳しい仕様発表や実際のサービス展開が楽しみだね!
エンマち
2026年11月のIgnite 2026で詳細が紹介される予定だから、続報に注目していこう!
価格・仕様・条件は参照資料の取得時点の情報です。一次資料で確認できなかった数値も含まれるため、購入前に販売店・メーカーで最新の条件をご確認ください。
関連記事
電脳せどりはAIでここまで楽になる!利益商品の探し方と専用スキル
【必見】電話代行ができるAI『ピクル』がヤバすぎる件
AIの力で情報収集を効率化する方法5選|商品探し・X・メールまで
個人情報漏洩が相次ぐのはなぜ?企業の弱点と、今すぐできる3つの対策
Grok BotがiPhoneのアクションボタンに対応!音声会話やエージェント操作を即座に起動可能に
AI英会話「スピーク」に新機能「スピーク電話」が登場!過去の会話を記憶して台本なしで話せる
【必見】AIでクオリティの高いホームページを作る方法|参考サイトと2つのスキルを活用